DOTS와 Unreal Mass: 유창한 AAA 게임을 위한 CPU 캐시 효율성 및 병렬 처리 타겟팅
본 보고서는 게임 개발자의 관점에서 Unity와 Unreal Engine 5 게임 엔진의 데이터 지향 디자인(DOD)과 전통적인 객체 지향 프로그래밍(OOP) 접근 방식을 깊이 있게 비교합니다. 본 연구는 특히 메모리 레이아웃 최적화, CPU 캐시 활용도, 멀티스레딩 지원의 핵심 성능 결과를 분석하는 것을 목표로 합니다. 보고서는 현재 엔진 버전의 구체적인 코드 예제와 통합 단계를 통해 기술적 세부 사항을 파악합니다. 또한 Kena: Bridge of Spirits와 같은 타이틀에서 영감을 받아 고예산(AAA) 3인칭, 오픈 월드, 모바일 플랫폼용 게임에 대한 이러한 아키텍처 선택의 전략적 영향이 평가됩니다. 모든 주장은 제공된 출처를 바탕으로 증명됩니다.
핵심 패러다임 차이점: 데이터 저장 로직 및 성능 결과
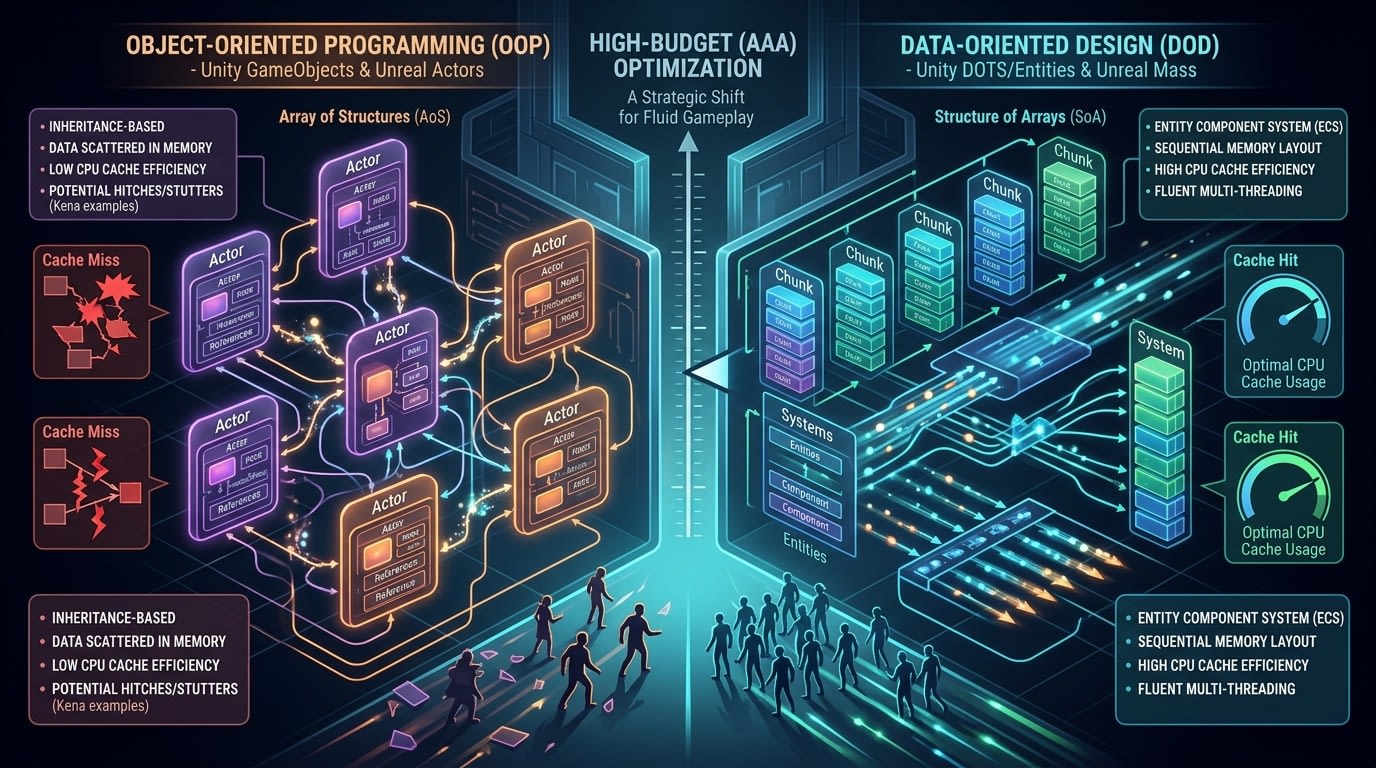
데이터 지향 디자인(DOD)과 객체 지향 프로그래밍(OOP) 간의 주요 차이점은 데이터를 논리적 단위로 그룹화하고 메모리에 저장하는 방식에 기반합니다. OOP는 데이터를 기능과 함께 패키징하는 객체에 초점을 맞추는 반면, DOD는 동일한 유형의 데이터를 함께 유지하여 메모리 액세스 패턴을 최적화하는 것을 목표로 합니다. 이러한 핵심 패러다임의 차이는 현대 컴퓨터 아키텍처의 성능 잠재력을 온전히 활용할 수 있는 능력 측면에서 매우 중요합니다 .
객체 지향 프로그래밍(OOP)은 일반적으로 "데이터를 객체 안에 저장"하는 로직에 의존합니다. 캐릭터 객체를 생각해보면, 이 객체는 Position(위치), Health(체력), Velocity(속도)와 같은 서로 다른 데이터 유형을 포함하는 속성을 갖게 됩니다. 각 캐릭터 객체는 메모리에서 고유한 주소 공간을 차지합니다. 복잡한 게임에 수백 또는 수천 개의 캐릭터가 있는 경우, 이러한 객체들은 메모리에 무작위로 분산됩니다. Update 루프에서 모든 캐릭터를 이동시키는 작업이 실행될 때, CPU는 각 캐릭터의 Position 데이터에 개별적으로 액세스해야 합니다. 이 경우 CharacterA 객체의 Position 정보와 Health 정보가 동일한 메모리 블록에 있을 가능성은 낮으며, 서로 다른 객체이기 때문에 서로 다른 주소에 있습니다. 마찬가지로 CharacterB의 Position 정보도 아마 CharacterA의 데이터와는 꽤 떨어져 있을 것입니다. 이는 CPU가 메모리에서 데이터를 가져와야 할 때 매번 서로 다르고 인접하지 않은 메모리 블록에 액세스하게 만듭니다. 이 상황은 현대 CPU의 구조와 상충되는 성능 병목 현상을 야기합니다 . Kena: Bridge of Spirits 같은 게임에서 발생하는 갑작스러운 끊김 현상과 FPS 저하는 이러한 OOP 기반의 캐시 친화적이지 않은 메모리 액세스 패턴으로 인해 발생하는 성능 문제의 전형적인 지표입니다 .
반면 데이터 지향 디자인(DOD)은 이 로직을 뒤집습니다. DOD는 객체가 아니라 그것들의 콘텐츠를 구성하는 데이터를 중심으로 삼으며, 동일한 유형의 데이터를 메모리에 최대한 조밀하고 연속적으로 저장하는 것을 목표로 합니다. 이 접근 방식의 가장 일반적이고 공식적인 구현은 엔티티 컴포넌트 시스템(ECS) 아키텍처입니다. ECS는 복잡한 개체를 단순한 "엔티티"로 정의하고, 이러한 엔티티의 동작과 속성을 독립적인 "컴포넌트(components)"를 통해 추가하며, 이 컴포넌트들을 사용하는 "시스템(systems)"에 의해 처리됩니다. 이 아키텍처의 핵심에는 Structure of Arrays(SoA) 또는 유사한 데이터 구조가 자리 잡고 있습니다 . SoA는 OOP의 AoS(Array of Structures) 로직과 달리 각 데이터 유형에 대해 별도의 배열을 생성하는 것을 의미합니다. 예를 들어, 모든 캐릭터의 Position 정보는 단 하나의 배열(positions[]) 내에, 모든 캐릭터의 Health 정보는 다른 배열(health[]) 내에, 그리고 모든 캐릭터의 Velocity 정보는 세 번째 배열(velocity[]) 내에 연속적으로 저장됩니다. 이 정렬 덕분에 모든 캐릭터의 위치를 동시에 업데이트하는 작업은 CPU에 단 한 번 큰 데이터 블록을 로드하는 것만을 요구합니다. 연속적인 메모리 액세스 패턴은 CPU의 L1, L2와 같은 고속 캐시를 효율적으로 사용할 수 있게 해줍니다. 첫 번째 데이터가 로드될 때 그 옆의 데이터들도 함께 캐시에 로드되며 이 데이터들은 반복해서 사용될 수 있기 때문입니다 . Unity의 ECS 문서에서는 데이터가 청크(Chunks)라는 이름의 고정 크기 연속 메모리 블록에 저장되며 이것이 CPU 캐시 라인과 얼마나 잘 호환되는지 강조하고 있습니다 . 이 간단하지만 효과적인 변경은 특히 대규모 데이터 세트에서 작동하는 알고리즘의 성능을 극적으로 향상시킵니다.
특징객체 지향 프로그래밍 (OOP)데이터 지향 디자인 (DOD/ECS)데이터 그룹화 로직"데이터를 객체 안에 저장" (AoS - Struct of Array)"동일한 데이터를 함께 저장" (SoA - Array of Struct)메모리 레이아웃데이터가 무작위로 분산된 메모리에 위치데이터가 메모리에 연속적이고 조밀하게 저장됨데이터 액세스 패턴산발적이고 교차하는 액세스가 흔함연속적이고 지역적인 액세스가 주를 이룸캐시 효율성일반적으로 낮음 (높은 Cache Miss 수)일반적으로 높음 (낮은 Cache Hit 수)아키텍처 구성상속(inheritance)과 추상화가 중심컴포넌트로 구성된 유연한 구조전형적용Unity GameObjects, Unreal ActorsUnity DOTS/Entities, Unreal Mass
이러한 기본 패러다임은 Unity와 Unreal Engine 5 같은 현대 게임 엔진에서 서로 다른 발전 경로를 따랐습니다. Unity는 OOP 기반의 GameObject 아키텍처를 유지하면서 DOTS(Data-Oriented Technology Stack)라는 완전히 새로운 데이터 지향 스택을 도입했습니다 . 이를 통해 개발자는 프로젝트의 서로 다른 부분에서 이 두 가지 접근 방식을 함께 사용할 수 있는 유연성을 갖게 됩니다. 예를 들어 사용자 인터페이스와 일부 특수 게임 메커니즘은 OOP로 관리되는 반면 물리 시뮬레이션이나 대량의 AI 유닛 제어는 DOD로 수행할 수 있습니다 . 그러나 Unreal Engine 5의 핵심 아키텍처는 UObject 상속을 바탕으로 깊이 OOP에 초점을 맞추고 있습니다 . 하지만 Unreal도 고성능이 요구되는 영역을 위해 특정 솔루션을 개발했습니다. 가장 중요한 것은 Mass Entity Framework입니다. Mass는 특히 수백 또는 수천 개의 AI 유닛이 동시에 작동하는 시나리오를 위해 설계된, 데이터 지향 연산을 수행할 수 있는 프레임워크입니다 . Mass의 목적은 Actor/Component 아키텍처의 성능 한계를 극복하는 것이며, 특정 작업(예: 대규모 유닛 관리)을 데이터 지향적인 방식으로 구성하여 병렬화할 수 있는 가능성을 제공합니다 . 또한 Chaos 물리 시스템 역시 데이터 지향적 접근 방식으로 진화했으며 시뮬레이션의 재계산을 방지하기 위한 캐싱 메커니즘을 포함합니다. 따라서 두 엔진 모두 OOP의 유연성과 DOD의 성능을 결합하는 방향으로 나아가고 있지만, 서로 다른 아키텍처 배경에서 비롯된 서로 다른 전략을 따르고 있습니다.
메모리 레이아웃 및 CPU 캐시 효율성 분석
현대 게임 엔진의 성능은 CPU가 RAM에서 데이터를 가져오는 속도보다 훨씬 빠르다는 사실에 의해 제한됩니다. 이 "폰 노이만 병목 현상"을 극복하는 방법은 CPU의 극도로 빠르지만 작은 L1 , L2 및 L3 캐시를 최대한 효율적으로 사용하는 것입니다 . CPU가 메모리 주소에 액세스할 때 해당 주소의 데이터를 메모리에서 읽어오는 대신 바로 옆에 있는 몇 바이트(일반적으로 64바이트의 "캐시 라인")도 함께 캐시로 가져옵니다 . 다음에 필요한 데이터가 이 캐시 라인 내에 있다면 CPU는 빠르게 액세스할 수 있으며, 이 상황을 "캐시 히트(cache hit)"라고 부릅니다. 그렇지 않다면 느린 RAM에서 새로운 데이터 블록을 로드해야 하며, 이는 중요한 성능 병목 현상인 "캐시 미스(cache miss)"라고 불립니다. 데이터 지향 디자인(DOD)은 특히 OOP가 유발하는 분산된 메모리 액세스 패턴을 피함으로써 캐시 히트율을 높이는 것을 목표로 하는 아키텍처 솔루션을 제공합니다 .
객체 지향 프로그래밍(OOP) 접근 방식은 자연스럽게 분산된 메모리 레이아웃으로 이어집니다. Character 객체는 position, health, rotation과 같은 서로 다른 데이터 유형을 포함하는 멤버를 보유합니다. 각각의 Character 객체는 메모리에서 고유한 주소로 시작합니다. 루프에서 모든 캐릭터의 update 함수를 호출하려고 할 때 CPU는 메모리에 있는 각 Character 객체의 시작점으로 이동해야 합니다. 이러한 객체들의 멤버(데이터)가 서로 가까이 있을 필요는 없습니다. 예를 들어 CharacterA의 position 멤버와 CharacterB의 health 멤버는 아마 동일한 64바이트 캐시 라인 내에 존재하지 않을 것입니다. 이는 데이터를 순차적으로 처리하고자 할 때 CPU가 계속해서 서로 다르고 먼 메모리 주소로 점프해야 하도록 만듭니다. 매번 새로운 주소로 이동하는 것은 이전 캐시 라인을 무효화하는 것을 의미하며, 이는 높은 비율의 캐시 미스로 이어진니다. 모바일 플랫폼의 경우 이 상황이 훨씬 더 중요합니다. 더 적은 전력으로 더 많은 연산을 수행할 수 있는 것은 모바일 기기의 핵심 장점이기 때문입니다 .
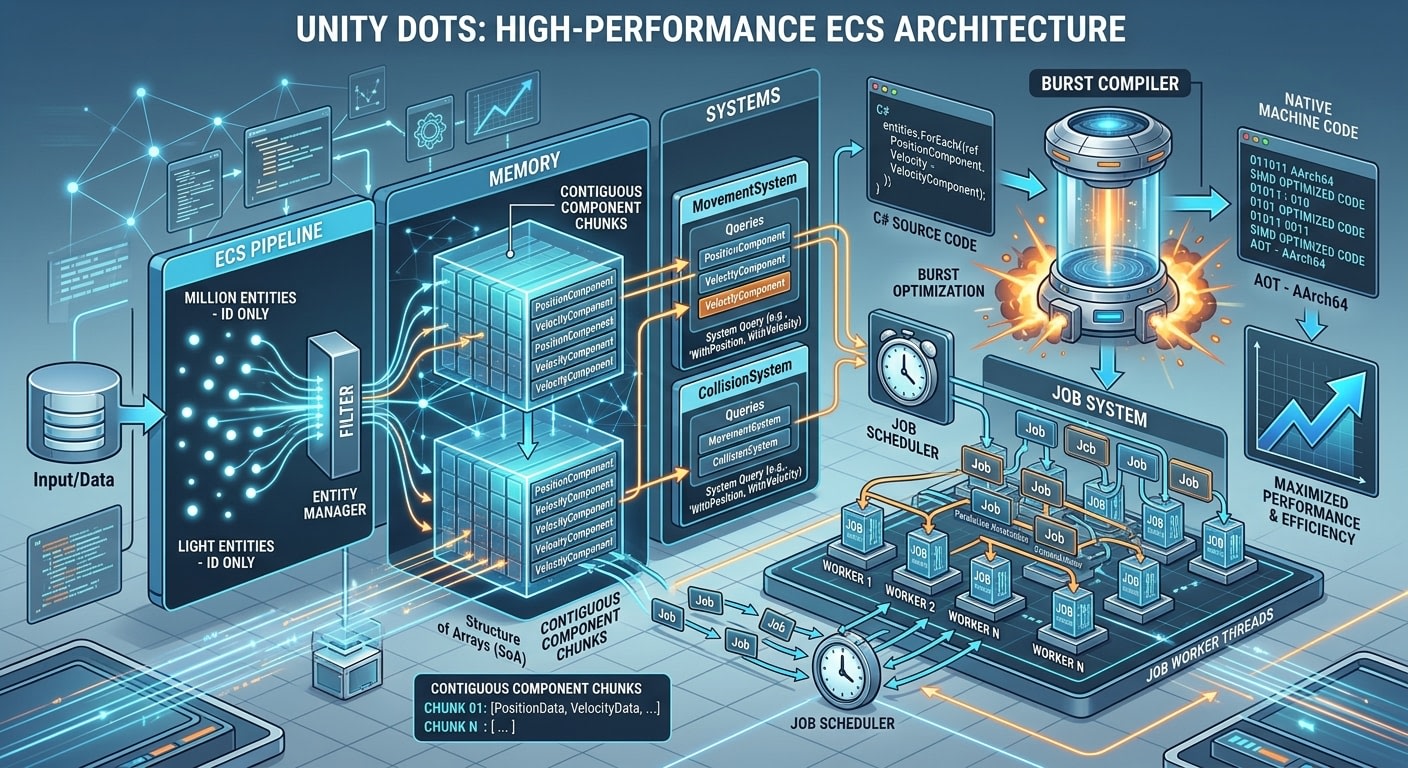
데이터 지향 디자인(DOD)은 이 문제에 대한 직접적인 해결책을 제시합니다. Unity의 DOTS 아키텍처는 데이터를 "청크(Chunk)"라는 이름의 고정 크기, 완전히 연속적인 메모리 블록에 저장합니다 . 각각의 청크는 동일한 유형의 컴포넌트들로 구성된 "Structure of Arrays" (SoA) 배열을 포함합니다. 예를 들어 Translation(위치)이라는 컴포넌트와 관련된 모든 데이터는 단 하나의 연속적인 메모리 블록에 저장됩니다. 마찬가지로 Rotation(회전) 데이터는 다른 청크나 동일한 청크 내의 별도 SoA 배열에 연속적으로 위치합니다. 이 정렬 덕분에 시스템(예: MovementSystem)은 모든 Translation 데이터를 단 하나의 for 루프 내에서 처리할 수 있습니다. CPU는 이 루프를 실행할 때 메모리에서 단 한 번 커다란 데이터 블록을 로드하고 이 데이터를 반복해서 사용합니다. 관련된 모든 데이터가 서로 매우 가깝기 때문입니다. 이 상황은 CPU 캐시를 효율적으로 사용하는 것을 가능하게 하며 캐시 미스율을 극적으로 감소시킵니다 . Unity의 ECS 아키텍처에 있는 엔티티들이 자신이 포함하는 모든 컴포넌트 데이터를 단 하나의 메모리 블록에 모으는 것은 이러한 효율성을 극대화합니다 . 더 중요한 것은 Unity의 DOTS 아키텍처에서 메모리 내 데이터 레이아웃이 CPU 자체의 메모리 정렬(예: L1 데이터 캐시의 64바이트 라인)과 완벽하게 일치한다는 점입니다 . 데이터 필드의 크기와 정렬은 캐시 라인의 요구 사항에 맞게 최적화됩니다. 이는 특히 Arm Cortex-X4와 같은 현대 모바일 CPU에서 중요한 장점으로 전환됩니다. 이러한 아키텍처의 성능은
메모리 대역폭과 캐시 효율성이 최고 수준에 도달하는 것과 직접적으로 연관되어 있기 때문입니다.
Unreal Engine 5에도 유사한 철학이 존재합니다. Mass Entity Framework는 엔티티와 그 컴포넌트를 Archetype이라는 복잡한 데이터 구조에 따라 그룹화하여 메모리에 더 효율적으로 저장할 수 있도록 합니다. Archetype은 특정 컴포넌트 셋을 정의합니다. 예를 들어 "이동할 수 있고 무기를 가진" Archetype을 생성할 수 있습니다. 그런 다음 이러한 유형의 컴포넌트를 가진 모든 엔티티(예: 500명의 병사)는 자동으로 이 Archetype에 속한 청크에 저장됩니다. 이는 쿼리를 더 효율적으로 실행하고 CPU 캐시의 낭비를 줄여줍니다. UE 5.7과 같은 새로운 버전에서 Mass를 향한 저수준 최적화가 이루어지는 것은 이 프레임워크가 성능 중심적이라는 명백한 증거입니다. 또한 Chaos 물리 시스템 역시 데이터 지향적 접근 방식으로 진화했으며 시뮬레이션의 재계산을 방지하기 위한 캐싱 메커니즘을 포함합니다. Chaos Cache Manager 같은 도구는 시뮬레이션을 한 번 계산하고 여러 번 재생할 수 있도록 보장함으로써 CPU가 동일한 작업을 반복해서 수행하는 것을 방지합니다. 이는 특히 동적 파괴나 유체 시뮬레이션과 같은 CPU 집약적 작업에서 중요한 성능 향상을 제공합니다.
결과적으로 메모리 레이아웃 최적화와 CPU 캐시 효율성은 현대 게임 엔진의 성능을 결정하는 가장 중요한 요소 중 하나입니다. OOP 접근 방식은 데이터 액세스 패턴을 자연스럽게 분산시켜 CPU 캐시의 잠재력을 낭비하는 반면, DOD는 이 문제에 직접적인 해결책을 제시합니다. Unity의 DOTS와 Unreal Engine 5의 Mass 프레임워크는 두 엔진 모두 분산된 메모리 액세스 패턴을 피하고 CPU 캐시를 효율적으로 사용하여 성능을 향상시키도록 설계되었습니다. 이 아키텍처 변경은 특히 Kena: Bridge of Spirits처럼 풍부하고 생동감 있는 세계를 제공하는 게임에서 원하는 유창한 경험을 제공하는 데 필수적인 중요성을 가집니다. 모바일 플랫폼의 경우 이러한 최적화는 더 적은 전력 소비로 더 많은 작업을 수행할 수 있는 기회를 제공하여 에너지 절약을 가능하게 합니다.
멀티스레딩 통합 및 병렬 처리 용량

최신 프로세서는 여러 개의 프로세서 코어를 가지고 있으며, 이 코어들 각각은 독립적으로 작동할 수 있습니다. 멀티스레딩은 이러한 병렬 처리 능력을 실제 게임 로직에 활용하는 능력입니다. 그러나 객체지향 프로그래밍(OOP) 기반의 코드 구조는 데이터 경합을 방지하기 위해 복잡한 동기화 메커니즘을 요구하며, 이는 예상치 못한 버벅거림과 CPU 코어의 유휴 상태로 이어질 수 있습니다. 데이터 지향 설계(DOD)는 아키텍처 수준에서 이러한 문제에 대한 해결책을 제시하여 코드의 병렬 실행을 자연스럽고 쉽게 만들어 줍니다.
객체지향 프로그래밍(OOP) 접근 방식에서 코드는 일반적으로 단 하나의 메인 스레드(예: Unreal의 GameThread 또는 Unity의 Main Thread)에서 동기적으로 실행됩니다. 이 스레드는 플레이어 입력, AI 로직, 물리 업데이트 등 많은 게임 로직을 처리합니다. 렌더링, 오디오, 물리 같은 다른 서브시스템들은 종종 별도의 스레드에서 실행되지만, 이 스레드들은 대개 메인 스레드와 독립적으로 작동합니다. 코드의 대부분이 단일 스레드에서 실행되기 때문에 CPU의 다른 코어들은 대개 유휴 상태로 대기합니다. 만약 개발자가 OOP 기반 프로젝트에 병렬성을 추가하고자 한다면, 데이터 경합을 방지하기 위해 lock, mutex 또는 semaphore 같은 동기화 메커니즘을 사용해야만 합니다. 이러한 메커니즘은 한 스레드가 임계 구역(예: 리스트에 대한 쓰기 작업)을 마칠 때까지 다른 스레드들이 대기하게 만들 수 있습니다. 대기 시간은 CPU 코어가 유휴 상태로 남게 됨을 의미하며, 이는 예상치 못한 버벅거림(hitch)과 전반적인 성능 저하로 이어진니다. Unreal Engine 5는 본질적으로 멀티스레딩 지원을 내장하고 있지만, 엔진이 때때로 단일 스레드에 갇히게 되어 개발자들이 이를 완전히 활용하기에는 제약이 있습니다. 이는 CPU의 잠재적 성능 중 상당 부분이 낭비되고 있음을 의미합니다.
데이터 지향 설계(DOD)는 병렬 처리를 위해 설계된 아키텍처 패러다임입니다. DOD는 데이터를 단일 위치에서 읽고 단일 위치에 쓰는 스레드 간의 데이터 경합을 제거하는 원칙을 채택합니다. Unity의 DOTS 아키텍처는 이러한 철학의 가장 명확한 예시이며, Job System과 Burst Compiler라는 두 가지 핵심 기술을 결합합니다. Job System은 코드를 조각으로 나누어 CPU의 서로 다른 코어에서 병렬로 실행할 수 있게 해줍니다. SystemBase 내의 Entities.ForEach 루프는 실제로는 하나의 작업(job)으로 컴파일됩니다. 이 작업은 단일 스레드에서 데이터가 수정되는 것을 방지하여 데이터 레이스(data race)를 제거합니다. 각각의 작업은 서로 다른 CPU 코어에서 안전하게 실행될 수 있습니다. 이를 통해 데이터 경합을 방지하기 위한 복잡한 동기화 코드 없이도 병렬화를 달성할 수 있습니다. Burst Compiler는 C# 코드를 고도로 최적화된 네이티브 C++ 코드로 변환하는 컴파일러 최적화 도구입니다. Burst는 LLVM 백엔드를 사용하여 코드를 C/C++ 수준에서 컴파일하므로 C++에서 얻을 수 있는 성능을 확보할 수 있게 해줍니다. 특히 루프, 수학적 계산 및 데이터 변환 작업에 매우 효율적입니다. 시스템의 모든 SystemBase(예: MovementSystem)는 실제로 작업으로 실행되며, Burst에 의해 최적화되어 서로 다른 CPU 코어에서 병렬로 실행될 수 있습니다. 이는 단일 스레드에서 데이터가 수정되는 것을 방지하여 데이터 레이스를 제거하고 병렬화의 안전성을 보장합니다.
Unreal Engine 5의 Mass Entity Framework 역시 멀티스레딩 활용을 용이하게 하는 유사한 원칙을 채택합니다. Mass는 특정 작업(예: 수백 마리 AI의 길찾기 로직 실행)을 데이터 지향 방식으로 조직하고 이를 여러 스레드에서 병렬로 실행함으로써 멀티스레딩 사용을 쉽게 만듭니다. Mass는 또한 렌더 그래프와 같은 다른 Unreal 스레드 모델들과 통합되어 작동하도록 설계되었습니다. 이를 통해 서로 다른 엔진 부품들이 서로 다른 스레드에서 병렬로 작동하여 전역 성능을 향상시킵니다. Unreal Engine 5.0 버전부터는 엔진 자체도 멀티스레딩 활용을 늘리기 위해 개선 작업을 거쳤습니다. 예를 들어, Vulkan RHI에서 이루어진 안정성 및 성능 업데이트는 데스크톱과 모바일 플랫폼 모두에서 더 나은 멀티스레딩 활용을 가능하게 했습니다.
구체적인 코드 예시 (Unity DOTS):
public class CharacterController_OOP : MonoBehaviour
{
    public float moveSpeed = 5f;
    void Update()
    {

        foreach(var character in allCharacters)
        {
            character.Move();
        }
    }
}

using UnityEngine;
using Unity.Entities;
using Unity.Transforms;
using Unity.Mathematics;
public class MovementSystem_DOD : SystemBase
{
    protected override void OnUpdate()
    {
        float deltaTime = Time.DeltaTime;

        Entities.ForEach((ref Translation translation, in Rotation rotation, in MoveSpeed speed) =>
        {
            translation.Value += speed.value * deltaTime * math.rotate(rotation.Value, new float3(0, 0, 1)).normalize();
        }).Schedule();
    }
}
이 예시에서 OOP 접근 방식은 메인 스레드에서 동기적으로 실행되는 반면, DOD 접근 방식인 OnUpdate 내의 Entities.ForEach 루프는 Job System에 의해 병렬로 처리될 수 있는 작업으로 스케줄링됩니다. 이 작업은 Burst에 의해 최적화되어 CPU의 서로 다른 코어에서 동시에 실행될 수 있습니다. 이는 단일 스레드에서 데이터가 수정되는 것을 방지하여 데이터 레이스를 제거하고 병렬화 안전성을 보장합니다.
결과적으로 DOD는 OOP가 수반하는 동기화의 어려움과 예상치 못한 버벅거림을 제거하여 멀티스레딩 활용을 자연스럽게 용이하게 만듭니다. Unity의 DOTS와 Unreal Engine 5의 Mass 프레임워크는 두 엔진 모두 분산된 메모리 접근 패턴을 피하고 CPU 캐시를 효율적으로 사용하여 성능을 향상시키도록 설계되었습니다. 이 아키텍처의 변경은 특히 Kena: Bridge of Spirits와 같이 풍부하고 생동감 있는 세계를 제공하는 게임에서 원하는 부드러운 경험을 보장하는 데 극히 중요합니다. 모바일 플랫폼의 경우 이러한 최적화는 더 적은 전력을 소비하면서 더 많은 작업을 수행할 수 있는 기회를 제공하여 에너지 절약을 가능하게 합니다.
Unity 에코시스템 내의 데이터 지향 기술 스택 (DOTS)
Unity는 OOP 기반의 GameObject 아키텍처를 유지하면서도, 동시에 고성능이 요구되는 애플리케이션을 위해 데이터 지향 기술 스택(DOTS)이라는 완전히 새로운 기술 스택을 제공합니다. DOTS는 데이터 지향 설계 원칙을 기반으로 메모리 레이아웃을 최적화하고, CPU 캐시 효율성을 높이며, 멀티스레딩 지원을 자연스러운 방식으로 제공합니다. 이 섹션에서는 DOTS의 핵심 구성 요소, 구체적인 코드 예시 및 통합 과정을 살펴봅니다.
DOTS의 기반은 Entities 패키지가 형성합니다. 이 패키지는 Entities, Component Data, Systems 같은 ECS(Entity Component System) 요소를 기본적인 방식으로 제공합니다. 여기서의 핵심 철학은 데이터를 기능성으로부터 분리하여 메모리에 더 효율적으로 저장하는 것입니다. 1. Entities: Entities는 어떠한 데이터도 담고 있지 않은, 고유 식별자(ID)를 가진 빈 컨테이너입니다. Entity는 객체가 아니라 단지 EntityId일 뿐입니다. 이로 인해 메모리에서 매우 가벼워지며, 빠르게 생성하고 파괴하는 것이 가능해집니다. 2. Component Data: 데이터를 담는 struct입니다. 반드시 struct여야 하며 상속을 사용할 수 없습니다. 예를 들어 Translation { public float3 Value; } 또는 Health { public int Value; }와 같은 간단한 데이터 저장 구조체가 정의됩니다. 이러한 struct들은 IComponentData 인터페이스를 구현합니다. 3. Systems: 이 데이터들을 처리하는 로직입니다. SystemBase 클래스에서 파생된 클래스들은 특정 데이터 유형(컴포넌트)을 선택하기 위해 쿼리(queries)를 사용하며 이 데이터들에 대해 연산을 수행합니다. OnUpdate 메서드는 작업으로 스케줄링되며 일반적으로 Entities.ForEach 루프를 포함합니다.
구체적인 코드 예시 (Unity DOTS): 아래 코드는 캐릭터의 이동을 OOP와 DOTS가 얼마나 다르게 다루는지 비교합니다:
public class PlayerController_OOP : MonoBehaviour
{
    public float moveSpeed = 5f;
    void Update()
    {

        float moveInput = Input.GetAxis("Horizontal");
        transform.Translate(Vector3.right * moveInput * moveSpeed * Time.deltaTime);
    }
}
public struct Translation : IComponentData
{
    public float3 Value;
}
public struct Rotation : IComponentData
{
    public quaternion Value;
}
public struct MoveSpeed : IComponentData
{
    public float value;
}
// 2. 게임 로직을 표현하는 시스템
public class MovementSystem : SystemBase
{
    protected override void OnUpdate()
    {

        float deltaTime = Time.DeltaTime;

        Entities
            .WithName("MoveEntities")
            .ForEach((ref Translation translation, in Rotation rotation, in MoveSpeed speed) =>
            {
                translation.Value += speed.value * deltaTime * math.normalize(math.mul(rotation.Value, new float3(0, 0, 1)));
            }).Schedule();


        Dependency.Complete();
    }
}
이 예시에서 DOD 접근 방식은 데이터가 메모리에 어떻게 그룹화되고 처리되는지 보여줍니다. Entities.ForEach 내의 루프는 Burst에 의해 최적화되어 서로 다른 CPU 코어에서 병렬로 실행될 수 있는 단일 작업으로 컴파일됩니다. 이는 단일 스레드에서 데이터가 수정되는 것을 방지하여 데이터 레이스를 제거하고 병렬화 안전성을 보장합니다.
통합 단계 (Unity DOTS): DOTS를 Unity 프로젝트에 통합하는 것은 표준 Unity 프로젝트를 생성하는 것으로 시작하며, 그 후 Package Manager를 통해 필요한 패키지들을 추가해야 합니다:
패키지 매니저: Edit > Project Settings > Packages 메뉴 또는 IDE 내부의 Window > Package Manager 메뉴로 이동합니다.
필수 패키지 추가: 프로젝트를 위해 다음과 같은 기본 DOTS 패키지들을 추가할 수 있습니다:
com.unity.entities: 기본 ECS 아키텍처를 제공하는 패키지입니다.com.unity.jobs: 잡 시스템을 실행하는 데 필요한 패키지입니다.com.unity.burst: C# 코드를 네이티브 C++ 코드로 변환하고 최적화하는 패키지입니다.com.unity.mathematics: DOTS를 위해 사용되는 벡터 및 행렬 연산 등의 기본 수학적 유형들을 제공합니다.com.unity.netcode.entities: 네트워크 지원 DOTS 애플리케이션에 필수적입니다.
데이터 구조 정의: IComponentData 인터페이스를 구현하는 struct들을 생성합니다. 이 struct들은 데이터를 운반하지만 함수를 포함할 수 없습니다.
시스템 생성: SystemBase 클래스로부터 상속받는 클래스들을 생성합니다. 이 클래스들은 OnUpdate, OnFixedUpdate 또는 OnCreate 같은 생명주기 메서드들을 오버라이드합니다.
렌더러 통합: DOTS로 생성된 Entities를 화면에 표시하기 위해 렌더러가 필요합니다. 초기에는 DOTS 데이터를 기존 GameObject에 반영하기 위해 Hybrid Renderer를 사용하는 것이 실용적입니다. 이를 통해 DOTS의 데이터 지향 아키텍처를 사용하면서도 기존 렌더링 파이프라인을 유지할 수 있습니다. 그 후, URP 또는 HDRP와 통합할 수 있는 Entities Graphics 패키지를 사용할 수 있습니다.
AAA 오픈월드 및 모바일 최적화를 위한 전략적 영향: Kena: Bridge of Spirits와 같은 게임들은 풍부하고 디테일한 환경(AA 오픈월드)과 부드럽고 반응성 있는 캐릭터 제어 모두를 요구합니다. 모바일 플랫폼은 제한된 CPU/GPU 성능과 배터리 수명 측면에서 추가적인 도전 과제를 더합니다.
성능과 부드러움: DOD는 특히 OOP 기반 프로젝트에서의 갑작스러운 버벅거림과 프레임 드랍을 줄이기 위한 가장 강력한 도구 중 하나입니다. Kena 게임에서의 스터터링(stutters) 문제는 DOD 접근 방식이 가져올 수 있는 차이를 명백히 드러냅니다. DOD는 CPU의 전체 성능을 활용하여 더 많은 데이터 처리 능력을 제공하며, 이는 더 안정적인 60 FPS 목표 달성을 가능하게 합니다.
모바일 플랫폼 최적화:
CPU 성능: 모바일 CPU들(예: Arm Cortex-X4)은 점점 더 강력해지고 있지만, 에너지 효율성은 여전히 핵심적인 요소입니다. DOD는 CPU의 유휴(idle) 시간을 최소화하여 더 적은 전력을 소비하면서도 더 많은 작업을 완수할 수 있도록 합니다. Arm의 Cortex-X4 아키텍처에서의 33% 대역폭 감소 같은 개선 사항들은 DOD로 구동되는 애플리케이션이 이로부터 더 큰 혜택을 누릴 수 있음을 의미합니다.
메모리 관리: 모바일 플랫폼에서는 메모리 사용량이 엄격하게 관리되어야 합니다. DOTS는 메모리에서 더 조밀하고 할당된 데이터와 함께 작동하여 전반적인 메모리 사용량을 줄일 수 있습니다. Unity의
AssetBundle압축 포맷 및 SVT(Virtual Texturing) 같은 기술들은 DOD의 데이터 구성과 결합될 때 모바일 플랫폼을 위해 매우 효율적인 구조를 형성할 수 있습니다.ProGuard 최소화: 안드로이드를 위한 ProGuard 최소화(minification) 같은 도구들은 DOD로 생성된 최적화된 코드와 함께 사용될 때 배포 크기와 성능을 더욱 향상시킬 수 있습니다.
결과적으로 Unity의 DOTS 스택은 OOP의 확장성 한계를 극복하기 위해 설계된 강력한 툴셋입니다. 개발자는 프로젝트의 성능이 중요한 영역(물리, AI, 파티클 시스템)에서 DOTS를 사용하여 기존 OOP 기반 구조를 망치지 않고 하이브리드 접근 방식을 따를 수 있습니다.
언리얼 엔진 5의 성능 중심 아키텍처 접근 방식: Mass와 Chaos
언리얼 엔진 5는 기본 아키텍처인 UObject 상속을 통해 깊이 있는 객체 지향 프로그래밍(OOP) 중심 구조를 가지고 있습니다. 그러나 AAA급 게임에 필요한 고성능 및 확장성 요구 사항으로 인해 엔진 자체도 진화하여 데이터 중심 접근 방식을 채택하게 되었습니다. 언리얼 엔진 5는 이러한 요구를 충족하기 위해 Mass Entity Framework와 Chaos Physics라는 두 가지 주요 성능 중심 아키텍처 접근 방식을 제공합니다. 이 두 시스템은 언리얼의 OOP 기반 구조를 넘어서 데이터 중심 디자인 원칙을 채택함으로써, 특히 대규모 시뮬레이션 및 물리 시뮬레이션에서 결정적인 성능 향상을 제공합니다.
Mass Entity Framework: 데이터 중심 게임플레이 Mass는 언리얼 엔진 5에서 데이터 중심 연산을 위해 설계된 프레임워크로, 특히 수백 또는 수천 개의 게임 유닛이 동시에 관리되는 시나리오를 위해 개발되었습니다. Mass는 언리얼 게임플레이를 대체하는 것이 아니라, 기존 Actor/Component 아키텍처 위에 구축된 데이터 중심의 병렬 처리에 적합한 레이어로 설계되었습니다. 핵심 철학은 방대한 양의 유사한 데이터 세트를 메모리에 더 효율적으로 그룹화하고, 이를 여러 스레드에서 병렬로 처리하여 성능을 극대화하는 것입니다.
Mass 아키텍처의 핵심 구성 요소는 다음과 같습니다:
엔티티(Entity): Mass에서 엔티티는 데이터를 전혀 담지 않은, 고유 식별자만 가진 빈 컨테이너입니다. 이로 인해 Unity의
Entity처럼 극도로 가벼워집니다.컴포넌트(Component): 데이터를 담는 데이터 구조입니다.
float값, 벡터 또는 복잡한 구조체일 수 있습니다. 컴포넌트는 메모리에서 데이터를 그룹화할 수 있게 해줍니다.시스템(System): 특정 컴포넌트를 가진 엔티티들을 선택하여 처리하는 로직입니다. 이 시스템들은 데이터를 처리할 때 병렬화될 수 있습니다.
아키타입(Archetype): 이는 Mass 아키텍처에서 가장 중요하고 독창적인 구성 요소입니다.
아키타입(Archetype)은 특정 컴포넌트 세트를 정의합니다. 예를 들어, "Position", "Velocity", "AIController" 컴포넌트를 가진아키타입을 생성할 수 있습니다. 그런 다음 이러한 종류의 컴포넌트를 가진 모든 엔티티(예: 1000개의 적 유닛)는 자동으로 이아키타입에 속하는 메모리 블록에 저장됩니다. 이를 통해 쿼리 실행이 더 효율적으로 이루어지고 CPU 캐시 낭비가 줄어듭니다.
구체적인 코드 예시 (언리얼 엔진 5 - Mass): Mass는 일반적으로 C++ 또는 Blueprint 내의 전용 노드를 통해 사용됩니다. 아래는 Mass 시스템의 기본 구조에 대한 전반적인 아이디어를 제공하는 의사 코드 예시입니다:
USTRUCT(BlueprintType)
struct FPositionComponent
{
    GENERATED_BODY()
    UPROPERTY(EditAnywhere, BlueprintReadWrite, Category = "Components")
    FVector Location;
};
USTRUCT(BlueprintType)
struct FVelocityComponent
{
    GENERATED_BODY()
    UPROPERTY(EditAnywhere, BlueprintReadWrite, Category = "Components")
    FVector Velocity;
};

class FMovementSystem : public FGlobalComponentSystem
{
public:
    virtual void Tick(float DeltaTime) override
    {

        Query.ForEach(
            [&](FEntityHandle Entity, FMutableRef<FPositionComponent> PositionComp, FMutableRef<FVelocityComponent> VelocityComp)
            {

                PositionComp->Location += VelocityComp->Velocity * DeltaTime;
            });
    }
};
// 3. 시스템 등록 및 엔진 통합
IMPLEMENT_MODULE(MyModule, MyModuleName);
이 예시에서 Query.ForEach 호출은 Mass의 데이터 중심 구조의 기초를 형성합니다. 시스템은 지정된 컴포넌트를 가진 모든 엔티티를 선택하고 단일 루프에서 해당 엔티티의 데이터를 처리합니다. 이 루프는 언리얼의 내부 병렬 처리 메커니즘에 의해 서로 다른 스레드에서 실행될 수 있습니다. UE 5.7과 같은 최신 버전에서도 Mass를 위한 저수준(low-level)
최적화가 계속되고 있으며, 이는 프레임워크가 성능 중심적임을 명백히 증명합니다.
Chaos 물리 및 캐싱:
Chaos는 언리얼 엔진 5의 기본 물리 엔진이며 OOP 아키텍처의 일부로 설계되었습니다. 그러나 Chaos 역시 데이터 중심 원칙을 채택했으며, 특히 CPU 집약적인 시뮬레이션의 성능을 향상시키도록 설계되었습니다. Chaos는 파괴 가능한 조인트(breakable joints) 및 충돌 반발(collision restitution) 같은 기능을 지원합니다.
Chaos의 성능 중심 측면에서 가장 중요한 특징은 시뮬레이션 캐싱 기능입니다. 복잡한 물리 시뮬레이션(예: 대형 건물의 파괴)이 매 프레임 재계산된다면 이 작업은 너무 큰 비용을 소모합니다. Chaos Cache Manager는 이 문제를 해결하기 위해 설계되었습니다. 개발자가 시뮬레이션을 기록하면 엔진은 이 시뮬레이션의 복사본을 메모리나 디스크에 저장합니다. 그 후 시뮬레이션이 다시 재생될 때 엔진은 저장된 데이터를 사용하여 재계산을 수행하지 않으므로 상당한 CPU 시간을 절약할 수 있습니다. 이는 반복되는 효과나 동적 객체에 특히 매우 효과적입니다. 그러나 이 시스템이 올바르게 작동하려면 세심하게 조정해야 합니다. 잘못 구성하면 캐시 데이터가 동기화되지 않아 객체가 원래 위치로 튀어오를 수 있습니다.
통합 단계 (언리얼 엔진 5):
Mass 및 Chaos 같은 시스템을 언리얼 프로젝트에 통합하는 것은 엔진의 기본 구성에 이미 포함되어 있는 경우가 많기 때문에 비교적 쉽습니다.
플러그인 활성화: 프로젝트 설정(Settings > Plugins > Gameplay > Mass)에서 Mass 플러그인을 활성화할 수 있습니다.
Blueprint 또는 C++ 개발: Mass는 Blueprint 에디터 내의 Mass Entity 팔레트에서 사용하거나 C++ 코드를 직접 작성하여 사용할 수 있습니다. Blueprint 지원은 빠른 프로토타이핑에 이상적입니다.
시스템 생성:
MassEntityPlayerController와 같은 기성 컨트롤러를 사용하거나FMassExecutionContext를 통해 C++ 내에서 자신만의 시스템을 생성하여 시작할 수 있습니다.Chaos 설정: Chaos 물리 설정은 Project Settings > Chaos Physics 아래에 있습니다. 이 설정에서 충돌 반발(collision restitution)과 같은 기능을 활성화할 수 있습니다. Chaos 캐싱을 위해 Chaos Solver Settings 내의
bEnableCache옵션을 활성화해야 합니다.
전략적 영향:
언리얼 엔진 5의 데이터 중심 접근 방식은 특히 AAA급 오픈 월드 및 모바일 플랫폼에 전략적 중요성을 가집니다. Kena 스타일의 게임에는 플레이어 앞에 지속적으로 활기가 존재하는 광대한 세계가 있습니다. 이 세계의 NPC나 객체의 즉각적인 동작이 OOP 스타일로 관리될 경우, 매 프레임 수백 개의 서로 다른 메모리 주소에 접근하게 되며 이는 성능 저하(끊김 현상)를 유발합니다. DOD 접근 방식은 이러한 게임에서 원하는 부드러운 경험을 제공하는 데 필수적입니다. 모바일 플랫폼의 경우 CPU 캐시 효율성이 훨씬 더 중요합니다. 더 적은 전력으로 더 많은 연산을 수행하는 것은 모바일 기기의 핵심 장점입니다. 언리얼 엔진 5의 Niagara 파티클 시스템도 SVT(Virtual Texture)와 같은 기술과 함께 사용될 때 시뮬레이션 캐싱을 통해 상당한 성능 및 메모리 개선을 제공할 수 있습니다.
결과적으로 언리얼 엔진 5는 OOP 기반 구조를 유지하면서도 성능 중심의 요구를 충족하기 위해 강력한 데이터 중심 레이어인 Mass와 Chaos를 개발했습니다. 이 시스템들은 개발자에게 대규모, 데이터 집약적 시뮬레이션에 필요한 성능을 제공하는 동시에 엔진의 핵심 아키텍처를 변경하지 않고 통합된 방식으로 작동합니다.
전략적 영향과 생산성 비용: AA 오픈월드 및 모바일 플랫폼을 위한 평가
데이터 중심 설계(DOD)와 객체 지향 프로그래밍(OOP) 중 어떤 것을 선택하느냐는 단순한 기술적 선호를 넘어 게임의 성공을 좌우하는 전략적 결정이 됩니다. 특히 Kena: Bridge of Spirits와 같이 풍부하고 유연하며 광대한 세계를 가진 AAA급 게임과 리소스가 제한된 모바일 플랫폼에서 이 결정은 성능, 개발 속도, 그리고 게임 플레이 경험에 깊은 영향을 미칩니다. DOD는 특히 OOP의 확장성 한계를 극복하기 위해 설계된 강력한 패러다임이지만, 이러한 이점들은 학습 곡선 및 통합 비용과 같은 요인들과 상호 비교되어야 합니다.
AAA 오픈월드 및 유연성 문제에 대한 전략적 영향:
Kena: Bridge of Spirits는 풍부한 신화적 세계, 유연한 캐릭터 조작, 세밀한 주변 요소들을 제공하는 게임으로 돋보입니다. 스팀 커뮤니티 포럼의 토론에서는 게임의 성능 문제("stutter" 및 "FPS drops")가 언급되었습니다 . 이러한 문제들의 기면에 놓인 근본적인 기술적 원인은 대개 OOP 기반 아키텍처의 확장성 한계입니다. OOP에서는 씬 안의 모든 엔티티(NPC, 오브젝트, 파티클 시스템)가 저마다의 GameObject와 여기에 연결된 컴포넌트들을 가지고 있습니다. 이 GameObject들은 메모리에 분산되어 저장되기 때문에, 매 프레임마다 이 엔티티들 전부를 업데이트하는 것은 CPU에 수백 가지의 서로 다른 메모리 주소에 접근하라는 명령을 내리게 됩니다. 이는 높은 수의 CPU 캐시 미스로 이어져 프로세서가 느린 RAM으로부터 데이터를 가져오도록 강제하며, 이는 가시적인 끊김 현상(순간적인 멈춤)을 유발합니다. DOD는 이 문제에 대한 직접적인 해결책을 제공합니다. Unity의 DOTS나 Unreal Engine 5의 Mass 같은 프레임워크는 유사한 데이터 유형(예: 모든 NPC의 위치 데이터)을 메모리에 연속적으로 저장합니다. 이는 단일 스레드가 이 모든 데이터를 한 번에 메모리에서 가져와 처리할 수 있음을 의미하며, 이는 CPU 캐시 적중률과 전반적인 성능을 극적으로 향상시킵니다. 이 아키텍처는 Kena와 같은 게임에서 요구되는 유연한 경험을 제공하는 데 있어 생명과도 같이 중요합니다. DOD는 CPU의 완전한 성능을 활용하여 더 많은 데이터 처리 능력을 제공하며, 이를 통해 더 안정적인 60 FPS 목표 설정을 가능하게 합니다.
모바일 플랫폼 최적화를 위한 전략적 영향:
모바일 플랫폼은 데스크톱이나 게임 콘솔에 비해 더 제한된 자원을 가지고 있습니다. 더 적은 CPU 성능, 더 적은 RAM, 그리고 결정적 요소인 배터리 수명입니다. 따라서 모바일 게임 개발자에게 에너지 효율성과 메모리 관리운용은 게임의 성공 지표 중 하나가 됩니다.
에너지 효율성: 모바일 프로세서(예: Arm Cortex-X4)는 점점 더 강력해지고 있지만, 에너지 효율성은 여전히 핵심적인 요소입니다 . DOD는 CPU의 유휴 상태(idle) 시간을 최소화하여 더 적은 전력을 소비하면서 더 많은 작업을 완료할 수 있도록 합니다. Arm의 Cortex-X4 아키텍처에서의 33% 대역폭 감소와 같은 개선 사항은 DOD로 구동되는 애플리케이션이 이로부터 훨씬 더 많은 이점을 얻을 수 있음을 의미할 수 있습니다 . 더 적은 CPU 사용량은 기기가 덜 발열하게 하고 배터리가 더 천천히 닳도록 돕기도 합니다.
메모리 관리: 모바일 플랫폼에서는 메모리 사용량이 엄격하게 관리되어야 합니다. DOD는 메모리에 더 조밀하고 할당된 데이터로 작업함으로써 전반적인 메모리 사용량을 줄일 수 있습니다. Unity의
AssetBundle압축 포맷들 () 및 SVT(Virtual Texturing) 같은 기술들은 (), DOD의 데이터 구성과 결합될 때 모바일 플랫폼을 위한 매우 효율적인 구조를 형성할 수 있습니다. 또한, Unity의 DirectStorage 지원 () 및 셰이더 스트리밍과 같은 신기술들도 DOD의 데이터 관리 기반 아키텍처 이면의 비전을 뒷받침합니다 .생산성 및 개발 시간: 모바일 플랫폼 고유의 최적화(예: ProGuard 최소화) () 및 플랫폼 전용 API의 사용 ()이 DOD와 함께 고려될 때, 더욱 효율적인 코드베이스를 형성하여 이러한 최적화들이 더욱 효과적으로 작동하도록 합니다.
생산성 비용과 개발자 경험:
DOD가 제공하는 성능 이점은 뚜렷한 학습 곡선 및 초기 생산성 저하 비용과 상호 비교되어야 합니다.
전환의 어려움: 기존의 대규모 OOP 기반 프로젝트는 DOD 아키텍처로 완전히 전환될 수 없습니다. 보통 하이브리드 접근 방식이 채택됩니다. 일부 핵심 영역(물리, AI, 파티클 시스템)은 DOD로 이전되는 반면, 다른 영역들(UI, 일부 특수 게임플레이 메커니즘)은 기존 OOP 구조 아래에 남겨집니다. Unity의 Hybrid Renderer는 () 이러한 전환을 용이하게 하지만, 완전한 통합 문제를 내포하고 있습니다. Kena 게임에서의 문제들은 대개 기존 OOP 기반 구조의 확장성과 관련이 있으며, DOD와 같은 아키텍처 변경을 통해 해결될 수 있음을 시사합니다.
경험 수준: DOD는 특히 OOP 경험이 있는 개발자에게 학습 곡선이 매우 가파를 수 있습니다. 코드를 볼 때 "내가 소유한 객체가 있다"는 논리에서 "이 데이터 셋으로 무엇을 할 것인가"라는 논리로 전환하는 것은 어렵습니다. 이는 초기 개발 속도를 떨어뜨릴 수 있습니다.
도구 생태계: OOP 기반의 Unity와 Unreal은 수년에 걸쳐 개발되고 성숙해진 도구 생태계를 가지고 있습니다. DOTS와 Mass 같은 DOD 프레임워크 또한 발전하고 있으나, 여전히 부족한 부분이 있을 수 있으며 문서화가 더 최신 상태일 수 있습니다. 예를 들어, DOTS와 관련된 일부 오류들(예: 버스트 어셈블리 로딩 오류) ( )이나 Unreal의 Chaos Cache Manager와 같은 시스템들의 통합 ()은 여전히 개발자들에게 어려움을 야기할 수 있습니다.
비교 평가:
기준객체 지향 프로그래밍 (OOP)데이터 중심 설계 (DOD)학습 곡선낮음, 널리 쓰이고 대중적인 패러다임임높음, 새로운 철학이 요구됨생산성 (초기)높음, 빠른 프로토타이핑에 적합함낮음, 초기에 느릴 수 있음성능 (확장성)제한됨, 대규모 데이터셋에서 느려짐높음, 수백만 개의 데이터에서 잘 확장됨CPU 캐시 효율성낮음 (분산된 접근)높음 (연속적인 접근)병렬 처리 용이성중간 (동기화 필요)높음 (자연스러운 병렬 처리)모바일 플랫폼 적합성합리적이나, 에너지 효율성이 더 낮음높음, CPU를 더 효율적으로 사용함통합 (기존 프로젝트)쉬움, 기존 프로젝트들과 직접 호환됨어려움, 하이브리드 접근 방식이 필요함
결론 및 전략적 제안:
OOP와 DOD 사이의 선택은 게임의 규모, 타겟 플랫폼, 그리고 팀의 전문 분야와 같은 요소들에 따라 달라집니다. 소규모 및 중규모 프로젝트나 빠른 프로토타이핑을 위해서는 개발 속도와 유연성 측면에서 OOP가 유리할 수 있습니다. 하지만 Kena: Bridge of Spirits와 같이 유연하고 풍부하며 광대한 세계를 포함하는 AAA급 게임의 경우, DOD는 성능과 확장성 측면에서 대체 불가능한 선택지가 됩니다. 모바일 플랫폼의 경우 DOD는 에너지 효율성과 더 적은 메모리 사용량이라는 부가적 이점을 제공하여 DOD를 더욱 매력적으로 만듭니다. 개발자들은 프로젝트 요구 사항을 신중하게 분석해야 하며, OOP의 유연성과 DOD의 성능을 하나로 결합한 하이브리드 전략을 채택하는 것을 고려할 수 있습니다. 이를 통해 프로젝트의 서로 다른 부분에 올바른 아키텍처를 적용하는 것이 가능해질 것입니다.
*정보 : 이미지들은 Google Gemini 에 의해 생성되었습니다.